 LaunchRepo
llms.txt è un piccolo file Markdown nella radice di un sito web che indica agli agenti IA le pagine che contano. Si crea in pochi minuti, e molti consigli promettono che ti farà citare da ChatGPT o posizionare nella ricerca IA. Questo articolo separa ciò che è documentato da ciò che si spera. In breve: llms.txt non ti aiuta nella Ricerca Google, non ci sono prove che aumenti le citazioni nelle risposte IA, ed è davvero utile per un compito preciso: aiutare gli agenti a leggere la documentazione. Noi il nostro lo teniamo, e più sotto spieghiamo perché non è una contraddizione.
Cos’è llms.txt
La proposta è di Jeremy Howard ed è stata pubblicata su llmstxt.org il 3 settembre 2024. Oggi la pagina riporta la versione 2 della proposta ed è stata modificata l’ultima volta il 10 agosto 2026. L’idea: le pagine web sono fatte per le persone, con navigazione, script e layout attorno al testo. Un agente che deve capire un sito lavora meglio con un riassunto breve e pulito e con link a versioni Markdown delle pagine importanti.
Il formato è semplice e fisso:
- un H1 con il nome del sito (l’unica parte obbligatoria),
- un blockquote con un breve riassunto,
- paragrafi facoltativi con i dettagli,
- sezioni sotto titoli H2, ciascuna con un elenco di link e una nota facoltativa,
- per convenzione, una sezione chiamata “Optional” per i link che un agente può saltare.
La proposta dice chiaramente a cosa serve il file: viene letto “on demand, when an agent needs information about a topic while assisting a user” (su richiesta, quando un agente ha bisogno di informazioni su un argomento mentre assiste un utente). Non è un file di permessi. Le regole di accesso stanno in robots.txt, e llms.txt non può consentire né bloccare alcun crawler.
Un file minimo per un prodotto SaaS potrebbe essere così:
# ExampleApp

> ExampleApp schedules social posts for small teams. Paid plans from $9 per month; free plan with 3 channels.

## Docs
- [Quick start](https://example.com/docs/start.md): set up the first channel
- [API reference](https://example.com/docs/api.md): REST endpoints and limits

## Product
- [Pricing](https://example.com/pricing.md): plans, limits, refunds

## Optional
- [Changelog](https://example.com/changelog.md)
Cosa dice Google
Google ha risposto alla domanda in modo diretto. La sua guida all’ottimizzazione per le funzionalità di IA generativa elenca llms.txt tra le cose che puoi ignorare per la Ricerca Google:
“You don’t need to create new machine readable files, AI text files, markup, or Markdown to appear in Google Search (including its generative AI capabilities), as Google Search itself doesn’t use them.”
In sintesi: per comparire nella Ricerca Google, comprese le sue funzionalità di IA generativa, non servono nuovi file leggibili dalle macchine, file di testo per l’IA, markup o Markdown, perché la Ricerca Google non li usa.
Il 15 giugno 2026 Google ha aggiunto una nota di chiarimento, registrata nel log degli aggiornamenti della sua documentazione. Ora la guida dice:
“It’s completely fine if you decide to create and maintain LLMS.txt files (or other similar files) for other services or systems that use these files. Doing so will neither harm nor help your site’s visibility or rankings in Google Search, as Google Search ignores them.”
In sintesi: va benissimo creare e mantenere file LLMS.txt o simili per altri servizi che li usano; non danneggiano né aiutano visibilità e posizionamento nella Ricerca Google, perché la Ricerca Google li ignora.
Questo vale per la Ricerca Google, compresi AI Overviews e AI Mode. Non dice nulla su ChatGPT, Claude o Perplexity, e non dovremmo estenderlo fin lì.
E gli altri? Al 1° ottobre 2026 le pagine sui crawler di OpenAI, Anthropic e Perplexity descrivono i token di robots.txt come OAI-SearchBot, Claude-SearchBot e PerplexityBot come lo strumento per gestire la visibilità nella ricerca. Nessuna di queste pagine cita llms.txt come segnale di posizionamento o di citazione. Non abbiamo trovato dichiarazioni né in un senso né nell’altro, quindi “lo ignorano” sarebbe indimostrato quanto “lo usano”. La nostra guida sulla visibilità del prodotto nella ricerca IA spiega quei crawler e cosa decide davvero se puoi essere citato.
Cosa dicono i dati, e cosa non possono dire
Lo studio citato più spesso è l’analisi di SE Ranking su quasi 300.000 domini, pubblicata il 7 novembre 2025. I risultati:
- Il 10,13% dei domini aveva un file llms.txt.
- L’adozione era quasi uniforme tra i diversi livelli di traffico: 9,88% per i siti con 0–100 visite, 10,54% per quelli con 1.001–5.000, 8,27% per i siti con più di 100.000.
- La correlazione di Spearman e un modello XGBoost non hanno trovato alcun effetto di llms.txt sulla frequenza con cui un dominio veniva citato dai modelli IA. Eliminando la variabile, il modello è diventato più preciso.
Prima di usare questi numeri abbiamo letto la sezione sul metodo, e contano tre limiti:
- È uno studio di correlazione. Confronta i siti che hanno il file con quelli che non ce l’hanno. Non può mostrare cosa succederebbe se ne aggiungessi uno, né in un senso né nell’altro.
- I dati sulle citazioni non sono descritti nel dettaglio. L’articolo non dice quali modelli, quali prompt, quale periodo né quante risposte sono state campionate, e non pubblica dimensioni dell’effetto. Gli stessi autori definiscono i loro risultati “context-dependent” (dipendenti dal contesto).
- È precedente alla versione 2 della proposta e viene da un’azienda che vende il monitoraggio della visibilità nell’IA. Questo non lo rende sbagliato, ma è bene saperlo.
La lettura onesta è quindi: in questo dataset, avere un file llms.txt non è andato di pari passo con un numero maggiore di citazioni IA. È un dato utile e concorda con la dichiarazione di Google. Non è la prova che llms.txt non possa mai contare per nessun motore. Se qualcuno ti promette citazioni grazie a llms.txt, chiedi prove che mostrino una causa, non una correlazione. Noi non ne abbiamo viste.
Chi usa davvero llms.txt
Il file non è inutile. Ha trovato un compito reale, solo non quello che vende la maggior parte dei consigli:
- Le aziende di IA lo usano per la propria documentazione per sviluppatori. Il 1° ottobre 2026 developers.openai.com/llms.txt, platform.claude.com/llms.txt (con redirect da docs.claude.com) e docs.perplexity.ai/llms.txt rispondevano tutti con 200. La documentazione dei crawler di OpenAI si apre persino con “For the complete documentation index, see llms.txt.” (Per l’indice completo della documentazione, vedi llms.txt.)
- Lighthouse di Chrome lo controlla. Lighthouse ha una categoria sperimentale “Agentic browsing” (documentazione aggiornata l’ultima volta il 5 maggio 2026). Il suo audit di llms.txt segnala un errore del server quando il file non può essere recuperato e considera un file mancante (404) come non applicabile, “as providing the file is optional at the moment” (dato che per ora fornire il file è facoltativo). È un controllo di preparazione per gli agenti, non un fattore di posizionamento, e richiede Chrome 150 o successivo.
- I coding agent lo leggono per la documentazione. L’autore della proposta scrive che i file sono “used most heavily for software documentation, where coding agents follow them to find API references and tutorials” (usati soprattutto per la documentazione software, dove i coding agent li seguono per trovare riferimenti API e tutorial). È l’uso “on demand” descritto dalla proposta.
Lo schema: llms.txt aiuta quando un agente è già sul tuo sito, o sta per arrivarci, e ha bisogno di una mappa. Non è ciò che ce lo porta.
Cosa facciamo in LaunchRepo
Teniamo entrambi i file: /llms.txt e un più lungo /llms-full.txt. Ecco perché, con i fatti al 1° ottobre 2026:
- Mantenerli non ci costa nulla. Entrambi vengono generati in fase di build dagli stessi dati delle nostre pagine: prezzi, conteggi del catalogo, guide, confronti. Non possono discostarsi dal sito.
- Servono a un lettore reale. LaunchRepo è un toolkit per coding agent. Quando qualcuno chiede al proprio agente se LaunchRepo fa al caso del suo prodotto, un riassunto pulito con prezzi e limiti aiuta l’agente a rispondere correttamente.
- Il file llms.txt online pesa 63.009 byte con 19 sezioni e 177 link. È più grande del file che la proposta immagina, uno che entra comodamente nel contesto; gli agenti possono leggere le sezioni H2 che servono loro.
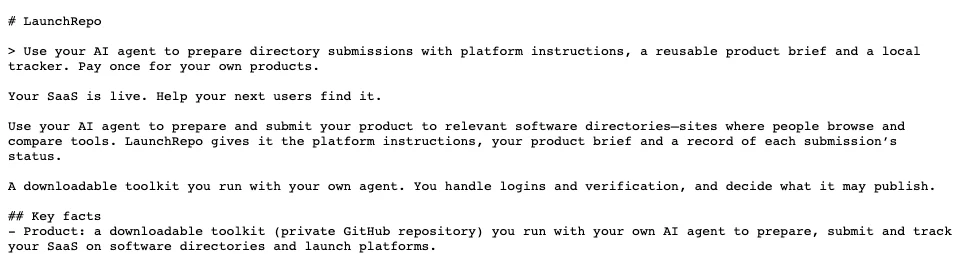
Ciò che non affermiamo: che il file ci porti traffico, citazioni o posizionamento. Non abbiamo analizzato i log del server per le richieste a /llms.txt, quindi non possiamo dire quanto spesso venga letto né da chi, e non tireremo a indovinare. Il nostro lavoro sui dati va in pagine che persone e motori possono citare, come l’indice degli stati delle directory e il nostro articolo su cosa possono e non possono dimostrare i backlink delle directory.
Dovresti crearne uno?
| La tua situazione | Ne vale la pena? | Perché |
|---|---|---|
| Hai documentazione API o per sviluppatori letta dagli agenti | Sì | È lo scopo per cui il formato è nato; le piattaforme di documentazione spesso lo generano |
| Vuoi posizionarti meglio su Google o in AI Overviews | No | La Ricerca Google ignora il file |
| Vuoi più citazioni in ChatGPT, Claude o Perplexity | Non come leva | Nessuna prova di un effetto; consenti invece i loro crawler di ricerca |
| Il tuo sito è comunque generato da dati strutturati | Costa poco aggiungerlo | Generalo, così non diventa mai obsoleto |
| Dovresti scriverlo e mantenerlo a mano | Bassa priorità | Dedica il tempo a una pagina con fatti che nessun altro ha |
Se ne crei uno, tienilo accurato: prezzo, piani, limiti e ciò che il prodotto non fa. Un agente che cita un prezzo superato dal tuo llms.txt fa più danni dell’assenza del file. E non creare pagine speciali solo per l’IA: le norme di Google sullo spam valgono anche per le risposte dell’IA generativa, e la sua guida cita espressamente i contenuti creati solo per manipolarle.
Domande frequenti
llms.txt migliora il posizionamento su Google?
No. Google afferma che la Ricerca Google ignora llms.txt e file simili, e che averne uno non danneggia né aiuta visibilità o posizionamento, anche in AI Overviews e AI Mode.
ChatGPT usa llms.txt?
OpenAI non l’ha detto. La sua documentazione sui crawler indica OAI-SearchBot e robots.txt come gli strumenti di controllo per la ricerca di ChatGPT e non menziona llms.txt. OpenAI pubblica però un llms.txt per la propria documentazione per sviluppatori, che gli agenti possono leggere su richiesta.
llms.txt è la stessa cosa di robots.txt?
No. robots.txt dice ai crawler a cosa possono accedere. llms.txt è una guida alla lettura per gli agenti e non può consentire né bloccare nulla. Per controllare i crawler IA, usa robots.txt con i loro token pubblicati.
llms.txt può bloccare l’addestramento dell’IA?
No. Per quello usa token di robots.txt come GPTBot, ClaudeBot o Google-Extended. Sono separati dai crawler di ricerca, quindi puoi bloccare l’addestramento e continuare a comparire nella ricerca IA.
Un file llms.txt danneggia il mio sito?
Google dice che nella Ricerca Google non danneggia né aiuta. L’unico rischio reale sono le informazioni obsolete: se il file dice qualcosa che le tue pagine non dicono più, gli agenti potrebbero ripetere la versione sbagliata.
Cos’è llms-full.txt?
Non fa parte della proposta llms.txt, che ruota attorno a un indice breve più versioni Markdown delle pagine. Alcuni siti, compreso il nostro, pubblicano un secondo file con il testo completo delle pagine importanti, così un agente può leggere tutto con una sola richiesta. Il nostro pesava 174.811 byte il 1° ottobre 2026.
Per vedere dove si colloca llms.txt rispetto a tutto ciò che influenza davvero le risposte IA, leggi la nostra guida sulla visibilità del prodotto nella ricerca IA. Se il tuo prossimo passo è farti trovare dove guardano le persone e i motori, consulta i prezzi.
Fonti, tutte verificate il 1° ottobre 2026: llmstxt.org (v2, 10 agosto 2026); Google Search Central, “Optimizing your website for generative AI features” (aggiornata il 10 luglio 2026) e aggiornamenti della documentazione del 15 giugno 2026; SE Ranking, “Does LLMs.txt impact your AI visibility and citations?” (7 novembre 2025); Chrome for Developers, audit llms.txt di Lighthouse e punteggio agentic browsing (5 maggio 2026); documentazione sui crawler di OpenAI, Anthropic e Perplexity; stato HTTP dei file llms.txt citati sopra; launchrepo.dev/llms.txt come servito il 1° ottobre 2026.