 LaunchRepo
llms.txt est un petit fichier Markdown placé à la racine d’un site web, qui indique aux agents IA les pages importantes. Il est facile à créer, et beaucoup de conseils promettent qu’il vous fera citer par ChatGPT ou mieux classer dans la recherche IA. Cet article distingue ce qui est documenté de ce qui relève de l’espoir. En bref : llms.txt ne vous aide pas dans la recherche Google, rien ne prouve qu’il augmente les citations par l’IA, et il est réellement utile pour une tâche précise : aider les agents à lire de la documentation. Nous gardons le nôtre, et nous expliquons plus bas pourquoi ce n’est pas une contradiction.
Ce qu’est llms.txt
La proposition vient de Jeremy Howard et a été publiée sur llmstxt.org le 3 septembre 2024. La page présente désormais la version 2 de la proposition et a été modifiée pour la dernière fois le 10 août 2026. L’idée : les pages web sont conçues pour des humains, avec de la navigation, des scripts et une mise en page autour du texte. Un agent qui doit comprendre un site travaille mieux avec un résumé court et propre et des liens vers des versions Markdown des pages importantes.
Le format est simple et figé :
- un H1 avec le nom du site (la seule partie obligatoire),
- une citation en bloc avec un court résumé,
- des paragraphes facultatifs avec des détails,
- des sections sous des titres H2, chacune contenant une liste de liens avec une note facultative,
- par convention, une section appelée “Optional” pour les liens qu’un agent peut ignorer.
La proposition dit clairement à quoi sert le fichier : il est lu « on demand, when an agent needs information about a topic while assisting a user », c’est-à-dire à la demande, lorsqu’un agent a besoin d’informations sur un sujet pendant qu’il aide un utilisateur. Ce n’est pas un fichier d’autorisations. Les règles d’accès se trouvent dans robots.txt, et llms.txt ne peut ni autoriser ni bloquer aucun robot.
Un fichier minimal pour un produit SaaS pourrait ressembler à ceci :
# ExampleApp

> ExampleApp schedules social posts for small teams. Paid plans from $9 per month; free plan with 3 channels.

## Docs
- [Quick start](https://example.com/docs/start.md): set up the first channel
- [API reference](https://example.com/docs/api.md): REST endpoints and limits

## Product
- [Pricing](https://example.com/pricing.md): plans, limits, refunds

## Optional
- [Changelog](https://example.com/changelog.md)
Ce que dit Google
Google a répondu directement à la question. Son guide d’optimisation pour les fonctionnalités d’IA générative range llms.txt parmi les éléments que vous pouvez ignorer pour la recherche Google :
“You don’t need to create new machine readable files, AI text files, markup, or Markdown to appear in Google Search (including its generative AI capabilities), as Google Search itself doesn’t use them.”
Autrement dit : inutile de créer de nouveaux fichiers lisibles par les machines, des fichiers texte pour l’IA, du balisage ou du Markdown pour apparaître dans la recherche Google, y compris dans ses fonctionnalités d’IA générative, car la recherche Google elle-même ne les utilise pas.
Le 15 juin 2026, Google a ajouté une précision, consignée dans le journal des mises à jour de sa documentation. Le guide indique désormais :
“It’s completely fine if you decide to create and maintain LLMS.txt files (or other similar files) for other services or systems that use these files. Doing so will neither harm nor help your site’s visibility or rankings in Google Search, as Google Search ignores them.”
En clair : vous pouvez tout à fait créer et tenir à jour des fichiers LLMS.txt (ou d’autres fichiers similaires) pour d’autres services ou systèmes qui les utilisent ; cela ne nuira ni n’aidera à la visibilité ou au classement de votre site dans la recherche Google, car la recherche Google les ignore.
Cela couvre la recherche Google, y compris AI Overviews et AI Mode. Cela ne dit rien de ChatGPT, de Claude ou de Perplexity, et il ne faut pas lui faire dire plus.
Et les autres ? Au 1er octobre 2026, les pages consacrées aux robots d’OpenAI, d’Anthropic et de Perplexity présentent des jetons robots.txt comme OAI-SearchBot, Claude-SearchBot et PerplexityBot comme le moyen de gérer la visibilité dans la recherche. Aucune ne mentionne llms.txt comme signal de classement ou de citation. Nous n’avons trouvé aucune déclaration dans un sens ou dans l’autre : « ils l’ignorent » serait donc aussi peu prouvé que « ils l’utilisent ». Notre guide sur la visibilité produit dans la recherche IA traite de ces robots et de ce qui décide réellement si vous pouvez être cité.
Ce que disent les données, et ce qu’elles ne peuvent pas dire
L’étude la plus souvent citée est l’analyse de SE Ranking portant sur près de 300 000 domaines, publiée le 7 novembre 2025. Ses résultats :
- 10,13 % des domaines avaient un fichier llms.txt.
- L’adoption était quasiment identique quel que soit le niveau de trafic : 9,88 % pour les sites de 0 à 100 visites, 10,54 % pour ceux de 1 001 à 5 000, 8,27 % pour ceux de plus de 100 000.
- La corrélation de Spearman et un modèle XGBoost n’ont trouvé aucun effet de llms.txt sur la fréquence à laquelle un domaine était cité par les modèles d’IA. Retirer la variable a rendu le modèle plus précis.
Nous avons lu la section méthodologique avant d’utiliser ces chiffres, et trois limites comptent :
- C’est une étude de corrélation. Elle compare les sites qui ont le fichier à ceux qui ne l’ont pas. Elle ne peut pas montrer ce qui se passerait si vous en ajoutiez un, dans un sens comme dans l’autre.
- Les données de citation ne sont pas décrites en détail. L’article ne précise ni les modèles, ni les prompts, ni la période, ni le nombre de réponses échantillonnées, et ne publie aucune taille d’effet. Les auteurs eux-mêmes qualifient leurs résultats de « context-dependent », c’est-à-dire dépendants du contexte.
- Elle est antérieure à la version 2 de la proposition et provient d’une entreprise qui vend du suivi de visibilité dans l’IA. Cela ne la rend pas fausse, mais c’est bon à savoir.
La lecture honnête est donc : dans ce jeu de données, avoir un fichier llms.txt n’allait pas de pair avec davantage de citations par l’IA. C’est utile, et cela concorde avec la déclaration de Google. Ce n’est pas la preuve que llms.txt ne pourra jamais compter pour aucun moteur. Si quelqu’un vous promet des citations grâce à llms.txt, demandez des preuves de causalité, pas de corrélation. Nous n’en avons vu aucune.
Qui utilise vraiment llms.txt
Le fichier n’est pas inutile. Il a trouvé un vrai rôle, simplement pas celui que vendent la plupart des conseils :
- Les entreprises d’IA l’utilisent pour leur propre documentation développeurs. Le 1er octobre 2026, developers.openai.com/llms.txt, platform.claude.com/llms.txt (redirigé depuis docs.claude.com) et docs.perplexity.ai/llms.txt renvoyaient tous un code 200. La documentation des robots d’OpenAI s’ouvre même sur « For the complete documentation index, see llms.txt. » (l’index complet de la documentation se trouve dans llms.txt).
- Lighthouse, l’outil de Chrome, le vérifie. Lighthouse dispose d’une catégorie expérimentale “Agentic browsing”, consacrée à la navigation par des agents (documentation mise à jour pour la dernière fois le 5 mai 2026). Son audit llms.txt signale une erreur serveur quand le fichier ne peut pas être récupéré et considère un fichier absent (404) comme non applicable, « as providing the file is optional at the moment », puisque fournir le fichier est pour l’instant facultatif. C’est un contrôle de préparation pour les agents, pas un facteur de classement, et il nécessite Chrome 150 ou une version ultérieure.
- Les agents de code le lisent pour consulter la documentation. L’auteur de la proposition écrit que ces fichiers servent surtout à la documentation logicielle, où les agents de code les suivent pour trouver références d’API et tutoriels : « used most heavily for software documentation, where coding agents follow them to find API references and tutorials ». C’est l’usage « on demand » que décrit la proposition.
Le schéma : llms.txt aide quand un agent est déjà sur votre site, ou sur le point d’y arriver, et a besoin d’une carte. Ce n’est pas lui qui l’y amène.
Ce que nous faisons chez LaunchRepo
Nous gardons les deux fichiers : /llms.txt et un /llms-full.txt plus long. Voici pourquoi, avec les faits au 1er octobre 2026 :
- Ils ne nous coûtent rien à maintenir. Les deux sont générés au moment du build à partir des mêmes données que nos pages : prix, effectifs du catalogue, guides, comparatifs. Ils ne peuvent pas diverger du site.
- Ils servent un vrai lecteur. LaunchRepo est une boîte à outils pour agents de code. Quand quelqu’un demande à son agent si LaunchRepo convient à son produit, un résumé propre avec les prix et les limites aide cet agent à répondre correctement.
- Le llms.txt en ligne pèse 63 009 octets, avec 19 sections et 177 liens. C’est plus que le fichier imaginé par la proposition, censé tenir facilement dans le contexte ; les agents peuvent lire uniquement les sections H2 dont ils ont besoin.
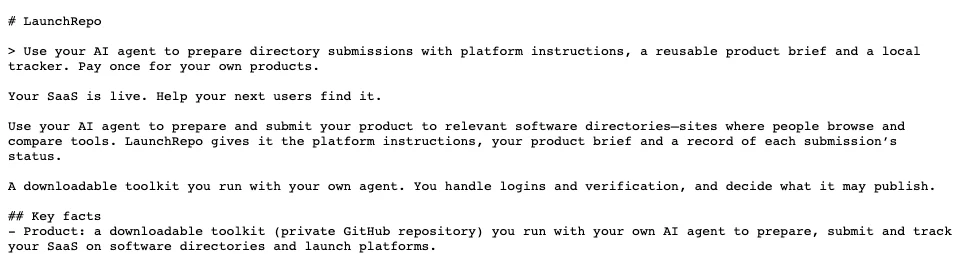
Ce que nous n’affirmons pas : que le fichier nous apporte du trafic, des citations ou des positions. Nous n’avons pas analysé nos journaux serveur pour repérer les requêtes vers /llms.txt ; nous ne pouvons donc pas dire à quelle fréquence il est lu ni par qui, et nous ne ferons pas de suppositions. Notre travail sur les données va à des pages que les gens et les moteurs peuvent citer, comme l’index de statut des annuaires et notre article sur ce que les backlinks d’annuaires peuvent et ne peuvent pas prouver.
Faut-il en créer un ?
| Votre situation | Ça vaut le coup ? | Pourquoi |
|---|---|---|
| Vous avez une documentation API ou développeurs lue par des agents | Oui | C’est pour cela que le format a été conçu ; les plateformes de documentation le génèrent souvent |
| Vous voulez un meilleur classement Google ou dans AI Overviews | Non | La recherche Google ignore le fichier |
| Vous voulez plus de citations dans ChatGPT, Claude ou Perplexity | Pas comme levier | Aucune preuve d’effet ; autorisez plutôt leurs robots de recherche |
| Votre site est de toute façon généré à partir de données structurées | Peu coûteux à ajouter | Générez-le pour qu’il ne soit jamais périmé |
| Vous l’écririez et le maintiendriez à la main | Faible priorité | Consacrez ce temps à une page avec des faits que personne d’autre n’a |
Si vous en créez un, gardez-le exact : prix, offres, limites et ce que le produit ne fait pas. Un agent qui cite un prix périmé tiré de votre llms.txt fait plus de dégâts que l’absence de fichier. Et ne créez pas de pages spéciales réservées à l’IA : le règlement de Google sur le spam s’applique aussi aux réponses d’IA générative, et son guide cite explicitement la création de contenu dans le seul but de les manipuler.
Questions fréquentes
llms.txt améliore-t-il le classement dans Google ?
Non. Google indique que la recherche Google ignore llms.txt et les fichiers similaires, et qu’en avoir un ne nuira ni n’aidera à la visibilité ou au classement, y compris dans AI Overviews et AI Mode.
ChatGPT utilise-t-il llms.txt ?
OpenAI ne l’a pas dit. Sa documentation sur les robots désigne OAI-SearchBot et robots.txt comme les leviers de contrôle pour la recherche ChatGPT et ne mentionne pas llms.txt. OpenAI publie en revanche un llms.txt pour sa propre documentation développeurs, que les agents peuvent lire à la demande.
llms.txt, est-ce la même chose que robots.txt ?
Non. robots.txt indique aux robots ce à quoi ils peuvent accéder. llms.txt est un guide de lecture pour les agents et ne peut rien autoriser ni bloquer. Pour contrôler les robots IA, utilisez robots.txt avec leurs jetons publiés.
llms.txt peut-il bloquer l’entraînement de l’IA ?
Non. Utilisez pour cela des jetons robots.txt comme GPTBot, ClaudeBot ou Google-Extended. Ils sont distincts des robots de recherche : vous pouvez donc bloquer l’entraînement tout en restant visible dans la recherche IA.
Un fichier llms.txt peut-il nuire à mon site ?
Google indique qu’il ne nuit ni n’aide dans la recherche Google. Le seul vrai risque, ce sont les informations périmées : si le fichier dit quelque chose que vos pages ne disent plus, les agents risquent de répéter la mauvaise version.
Qu’est-ce que llms-full.txt ?
Il ne fait pas partie de la proposition llms.txt, qui repose sur un index court et des versions Markdown des pages. Certains sites, dont le nôtre, publient un second fichier contenant le texte intégral des pages importantes, pour qu’un agent puisse tout lire en une seule requête. Le nôtre pesait 174 811 octets le 1er octobre 2026.
Pour voir la place de llms.txt à côté de tout ce qui influence réellement les réponses d’IA, lisez notre guide sur la visibilité produit dans la recherche IA. Si votre prochaine étape consiste à être référencé là où regardent les gens et les moteurs, consultez nos tarifs.
Sources, toutes vérifiées le 1er octobre 2026 : llmstxt.org (v2, 10 août 2026) ; Google Search Central, “Optimizing your website for generative AI features” (mis à jour le 10 juillet 2026) et mises à jour de la documentation du 15 juin 2026 ; SE Ranking, “Does LLMs.txt impact your AI visibility and citations?” (7 novembre 2025) ; Chrome for Developers, audit llms.txt de Lighthouse et notation de la navigation par agents (5 mai 2026) ; documentation des robots d’OpenAI, d’Anthropic et de Perplexity ; statut HTTP des fichiers llms.txt cités plus haut ; launchrepo.dev/llms.txt tel que servi le 1er octobre 2026.