 LaunchRepo
llms.txt es un pequeño archivo Markdown en la raíz de un sitio web que señala a los agentes de IA las páginas importantes. Es fácil de crear, y muchos consejos prometen que te hará aparecer citado en ChatGPT o posicionar en la búsqueda con IA. Este artículo separa lo documentado de lo que se espera. La versión corta: llms.txt no te ayuda en la Búsqueda de Google, no hay pruebas de que aumente las citas en IA y es realmente útil para una tarea concreta: ayudar a los agentes a leer documentación. Nosotros mantenemos el nuestro, y más abajo explicamos por qué eso no es una contradicción.
Qué es llms.txt
La propuesta es de Jeremy Howard y se publicó en llmstxt.org el 3 de septiembre de 2024. La página recoge ahora la versión 2 de la propuesta y se modificó por última vez el 10 de agosto de 2026. La idea: las páginas web están hechas para personas, con navegación, scripts y maquetación alrededor del texto. Un agente que necesita entender un sitio trabaja mejor con un resumen breve y limpio y enlaces a versiones en Markdown de las páginas importantes.
El formato es sencillo y fijo:
- un H1 con el nombre del sitio (la única parte obligatoria),
- una cita en bloque con un resumen breve,
- párrafos opcionales con detalles,
- secciones bajo encabezados H2, cada una con una lista de enlaces y una nota opcional,
- por convención, una sección llamada “Optional” con enlaces que un agente puede saltarse.
La propuesta dice con claridad para qué sirve el archivo: se lee «on demand, when an agent needs information about a topic while assisting a user», es decir, bajo demanda, cuando un agente necesita información sobre un tema mientras ayuda a un usuario. No es un archivo de permisos. Las reglas de acceso están en robots.txt, y llms.txt no puede permitir ni bloquear ningún rastreador.
Un archivo mínimo para un producto SaaS podría ser así:
# ExampleApp

> ExampleApp schedules social posts for small teams. Paid plans from $9 per month; free plan with 3 channels.

## Docs
- [Quick start](https://example.com/docs/start.md): set up the first channel
- [API reference](https://example.com/docs/api.md): REST endpoints and limits

## Product
- [Pricing](https://example.com/pricing.md): plans, limits, refunds

## Optional
- [Changelog](https://example.com/changelog.md)
Qué dice Google
Google respondió a la pregunta directamente. Su guía para optimizar de cara a las funciones de IA generativa incluye llms.txt entre las cosas que puedes ignorar para la Búsqueda de Google:
“You don’t need to create new machine readable files, AI text files, markup, or Markdown to appear in Google Search (including its generative AI capabilities), as Google Search itself doesn’t use them.”
En resumen: no hace falta crear archivos nuevos legibles por máquinas, archivos de texto para IA, marcado ni Markdown para aparecer en la Búsqueda de Google, incluidas sus funciones de IA generativa, porque la propia Búsqueda de Google no los usa.
El 15 de junio de 2026 Google añadió una nota aclaratoria, registrada en su historial de actualizaciones de la documentación. La guía dice ahora:
“It’s completely fine if you decide to create and maintain LLMS.txt files (or other similar files) for other services or systems that use these files. Doing so will neither harm nor help your site’s visibility or rankings in Google Search, as Google Search ignores them.”
Es decir: no pasa nada si creas y mantienes archivos LLMS.txt u otros similares para otros servicios o sistemas que los usen; no perjudicarán ni ayudarán a la visibilidad ni al posicionamiento de tu sitio en la Búsqueda de Google, porque la Búsqueda de Google los ignora.
Esto cubre la Búsqueda de Google, incluidos AI Overviews y AI Mode. No dice nada sobre ChatGPT, Claude ni Perplexity, y no deberíamos estirarlo hasta ahí.
¿Y los demás? A 1 de octubre de 2026, las páginas sobre rastreadores de OpenAI, Anthropic y Perplexity describen tokens de robots.txt como OAI-SearchBot, Claude-SearchBot y PerplexityBot como la forma de gestionar la visibilidad en la búsqueda. Ninguna menciona llms.txt como señal de posicionamiento ni de citas. No encontramos ninguna declaración en un sentido ni en otro, así que «lo ignoran» sería tan poco demostrado como «lo usan». Nuestra guía sobre visibilidad de tu producto en la búsqueda con IA trata esos rastreadores y lo que de verdad decide si te pueden citar.
Lo que dicen los datos y lo que no pueden decir
El estudio más citado es el análisis de SE Ranking sobre casi 300.000 dominios, publicado el 7 de noviembre de 2025. Sus resultados:
- El 10,13 % de los dominios tenía un archivo llms.txt.
- La adopción era casi igual en todos los niveles de tráfico: 9,88 % en sitios con 0 a 100 visitas, 10,54 % con 1.001 a 5.000 y 8,27 % en sitios con más de 100.000.
- La correlación de Spearman y un modelo XGBoost no encontraron ningún efecto de llms.txt en la frecuencia con la que los modelos de IA citaban un dominio. Al eliminar la variable, el modelo fue más preciso.
Leímos la sección de metodología antes de usar estas cifras, y hay tres límites importantes:
- Es un estudio de correlación. Compara sitios que tienen el archivo con sitios que no lo tienen. No puede mostrar qué pasaría si añadieras uno, ni para bien ni para mal.
- Los datos de citas no se describen en detalle. El artículo no dice qué modelos, qué prompts, qué periodo ni cuántas respuestas se muestrearon, y no publica tamaños del efecto. Los propios autores califican sus resultados de «context-dependent», es decir, dependientes del contexto.
- Es anterior a la versión 2 de la propuesta y procede de una empresa que vende seguimiento de visibilidad en IA. Eso no lo invalida, pero conviene saberlo.
Así que la lectura honesta es: en este conjunto de datos, tener un archivo llms.txt no iba de la mano de más citas en IA. Eso es útil y coincide con lo que dice Google. No demuestra que llms.txt nunca pueda importar para ningún buscador. Si alguien te promete citas gracias a llms.txt, pide pruebas que muestren causalidad, no correlación. Nosotros no hemos visto ninguna.
Quién usa realmente llms.txt
El archivo no es inútil. Ha encontrado una función real, solo que no es la que vende la mayoría de los consejos:
- Las empresas de IA lo usan para su propia documentación para desarrolladores. El 1 de octubre de 2026, developers.openai.com/llms.txt, platform.claude.com/llms.txt (redirigido desde docs.claude.com) y docs.perplexity.ai/llms.txt devolvían todos un 200. La documentación de rastreadores de OpenAI incluso empieza con «For the complete documentation index, see llms.txt.» (el índice completo de la documentación está en llms.txt).
- Lighthouse, de Chrome, lo comprueba. Lighthouse tiene una categoría experimental de “Agentic browsing”, navegación con agentes (documentación actualizada por última vez el 5 de mayo de 2026). Su auditoría de llms.txt marca un error del servidor cuando no se puede obtener el archivo y considera no aplicable la ausencia del archivo (404), «as providing the file is optional at the moment», porque por ahora ofrecerlo es opcional. Es una comprobación de preparación para agentes, no un factor de posicionamiento, y requiere Chrome 150 o posterior.
- Los agentes de programación lo leen para consultar documentación. El autor de la propuesta escribe que los archivos se usan sobre todo en documentación de software, donde los agentes de programación los siguen para encontrar referencias de API y tutoriales: «used most heavily for software documentation, where coding agents follow them to find API references and tutorials». Es el uso «on demand» que describe la propuesta.
El patrón: llms.txt ayuda cuando un agente ya está en tu sitio, o está a punto de llegar, y necesita un mapa. No es lo que lo lleva hasta allí.
Lo que hacemos en LaunchRepo
Mantenemos los dos archivos: /llms.txt y un /llms-full.txt más extenso. Estos son los motivos, con los datos a 1 de octubre de 2026:
- Mantenerlos no nos cuesta nada. Los dos se generan al compilar el sitio a partir de los mismos datos que nuestras páginas: precios, recuentos del catálogo, guías y comparativas. No pueden desalinearse del sitio.
- Tienen un lector real. LaunchRepo es un kit de herramientas para agentes de programación. Cuando alguien pregunta a su agente si LaunchRepo encaja con su producto, un resumen limpio con precios y límites ayuda a ese agente a responder correctamente.
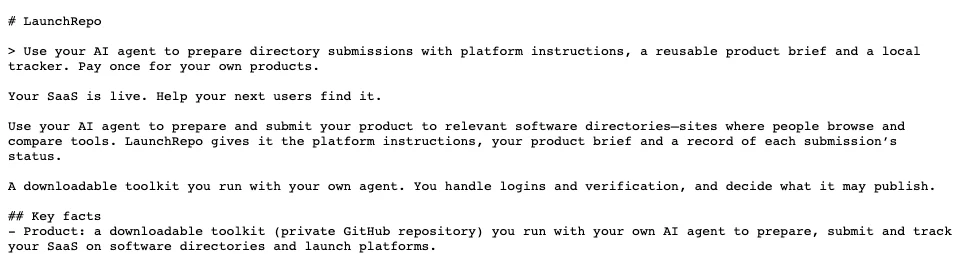
- El llms.txt publicado ocupa 63.009 bytes, con 19 secciones y 177 enlaces. Es más grande de lo que la propuesta imagina como un archivo que cabe con holgura en el contexto; los agentes pueden leer solo las secciones H2 que necesitan.
Lo que no afirmamos: que el archivo nos traiga tráfico, citas o posiciones. No hemos analizado los registros del servidor en busca de solicitudes a /llms.txt, así que no podemos decir con qué frecuencia se lee ni quién lo lee, y no vamos a adivinarlo. Nuestro trabajo con datos se centra en páginas que las personas y los buscadores pueden citar, como el índice de estado de los directorios y nuestro artículo sobre qué pueden demostrar y qué no los backlinks de directorios.
¿Deberías crear uno?
| Tu situación | ¿Merece la pena? | Por qué |
|---|---|---|
| Tienes documentación de API o para desarrolladores que leen agentes | Sí | Es para lo que se creó el formato; las plataformas de documentación suelen generarlo |
| Quieres mejores posiciones en Google o en AI Overviews | No | La Búsqueda de Google ignora el archivo |
| Quieres más citas en ChatGPT, Claude o Perplexity | No como palanca | No hay pruebas de un efecto; mejor permite sus rastreadores de búsqueda |
| Tu sitio ya se genera a partir de datos estructurados | Barato de añadir | Genéralo para que nunca se quede desactualizado |
| Lo escribirías y mantendrías a mano | Prioridad baja | Dedica el tiempo a una página con datos que nadie más tiene |
Si creas uno, mantenlo exacto: precio, planes, límites y lo que el producto no hace. Un agente que cita un precio desactualizado de tu llms.txt hace más daño que no tener archivo. Y no crees páginas especiales solo para la IA: las políticas contra el spam de Google también se aplican a las respuestas de IA generativa, y su guía señala expresamente la creación de contenido solo para manipularlas.
Preguntas frecuentes
¿llms.txt mejora el posicionamiento en Google?
No. Google afirma que la Búsqueda de Google ignora llms.txt y archivos similares, y que tener uno no perjudicará ni ayudará a la visibilidad ni al posicionamiento, tampoco en AI Overviews y AI Mode.
¿ChatGPT usa llms.txt?
OpenAI no lo ha dicho. Su documentación de rastreadores nombra OAI-SearchBot y robots.txt como los controles de la búsqueda de ChatGPT y no menciona llms.txt. OpenAI sí publica un llms.txt para su propia documentación para desarrolladores, que los agentes pueden leer bajo demanda.
¿llms.txt es lo mismo que robots.txt?
No. robots.txt indica a los rastreadores a qué pueden acceder. llms.txt es una guía de lectura para agentes y no puede permitir ni bloquear nada. Para controlar los rastreadores de IA, usa robots.txt con sus tokens publicados.
¿Puede llms.txt bloquear el entrenamiento de IA?
No. Para eso usa tokens de robots.txt como GPTBot, ClaudeBot o Google-Extended. Son independientes de los rastreadores de búsqueda, así que puedes bloquear el entrenamiento y seguir apareciendo en la búsqueda con IA.
¿Un archivo llms.txt perjudica a mi sitio?
Google dice que no perjudica ni ayuda en la Búsqueda de Google. El único riesgo real es la información desactualizada: si el archivo dice algo que tus páginas ya no dicen, los agentes pueden repetir la versión equivocada.
¿Qué es llms-full.txt?
No forma parte de la propuesta de llms.txt, que se centra en un índice breve y en versiones en Markdown de las páginas. Algunos sitios, entre ellos el nuestro, publican un segundo archivo con el texto completo de las páginas importantes, para que un agente pueda leerlo todo en una sola solicitud. El nuestro ocupaba 174.811 bytes el 1 de octubre de 2026.
Para ver dónde encaja llms.txt junto a todo lo que sí influye en las respuestas de IA, lee nuestra guía sobre visibilidad de tu producto en la búsqueda con IA. Si tu siguiente paso es aparecer donde buscan las personas y los buscadores, consulta los precios.
Fuentes, todas revisadas el 1 de octubre de 2026: llmstxt.org (v2, 10 de agosto de 2026); Google Search Central, “Optimizing your website for generative AI features” (actualizado el 10 de julio de 2026) y actualizaciones de la documentación del 15 de junio de 2026; SE Ranking, “Does LLMs.txt impact your AI visibility and citations?” (7 de noviembre de 2025); Chrome for Developers, auditoría de llms.txt de Lighthouse y puntuación de navegación con agentes (5 de mayo de 2026); documentación de rastreadores de OpenAI, Anthropic y Perplexity; estado HTTP de los archivos llms.txt mencionados arriba; launchrepo.dev/llms.txt tal como se servía el 1 de octubre de 2026.