 LaunchRepo
llms.txt 是放在网站根目录下的一个小型 Markdown 文件,用来为 AI 智能体指出重要的页面。它很容易制作,不少建议还承诺它能让你被 ChatGPT 引用,或在 AI 搜索中获得排名。本文把有文档依据的事实和一厢情愿的期望区分开来。简短的结论是:llms.txt 对 Google 搜索没有帮助,也没有证据表明它能提高 AI 引用,但它在一件事上确实有用:帮助智能体阅读文档。 我们自己保留了这个文件,下文会解释为什么这并不矛盾。
llms.txt 是什么
这项提案由 Jeremy Howard 提出,于 2024年9月3日发布在 llmstxt.org 上。该页面现在展示的是提案的第 2 版,最后修改于 2026年8月10日。它的思路是:网页是为人设计的,正文周围有导航、脚本和布局。需要理解一个网站的智能体,更适合读一份简短、干净的摘要,再加上指向重要页面 Markdown 版本的链接。
格式简单而固定:
- 一个写有网站名称的 H1(唯一的必需部分),
- 一个包含简短摘要的引用块,
- 可选的、包含细节的段落,
- H2 标题下的若干分区,每个分区是一组链接,可附说明,
- 按惯例,还有一个名为 “Optional” 的分区,放智能体可以跳过的链接。
提案清楚说明了这个文件的用途:它会被 “on demand, when an agent needs information about a topic while assisting a user” 读取,也就是说,当智能体在协助用户的过程中需要某个主题的信息时,才按需读取。它不是权限文件。访问规则写在 robots.txt 中,llms.txt 无法允许或屏蔽任何爬虫。
一个面向 SaaS 产品的最简文件可以是这样:
# ExampleApp

> ExampleApp schedules social posts for small teams. Paid plans from $9 per month; free plan with 3 channels.

## Docs
- [Quick start](https://example.com/docs/start.md): set up the first channel
- [API reference](https://example.com/docs/api.md): REST endpoints and limits

## Product
- [Pricing](https://example.com/pricing.md): plans, limits, refunds

## Optional
- [Changelog](https://example.com/changelog.md)
Google 怎么说
Google 直接回答了这个问题。它针对生成式 AI 功能的优化指南把 llms.txt 列为在 Google 搜索中可以忽略的事项之一:
“You don’t need to create new machine readable files, AI text files, markup, or Markdown to appear in Google Search (including its generative AI capabilities), as Google Search itself doesn’t use them.”
意思是:要出现在 Google 搜索(包括其生成式 AI 功能)中,你不需要创建新的机器可读文件、AI 文本文件、标记或 Markdown,因为 Google 搜索本身并不使用它们。
2026年6月15日,Google 补充了一条澄清说明,并记录在其文档更新日志中。指南现在写道:
“It’s completely fine if you decide to create and maintain LLMS.txt files (or other similar files) for other services or systems that use these files. Doing so will neither harm nor help your site’s visibility or rankings in Google Search, as Google Search ignores them.”
也就是说:为会使用这类文件的其他服务或系统创建和维护 LLMS.txt 完全没问题,但由于 Google 搜索会忽略它们,这样做对网站在 Google 搜索中的可见度和排名既无损害也无帮助。
这一说法覆盖 Google 搜索,包括 AI Overviews 和 AI Mode。它没有提及 ChatGPT、Claude 或 Perplexity,我们也不应把它延伸到那么远。
其他厂商呢?截至 2026年10月1日,OpenAI、Anthropic 和 Perplexity 的爬虫说明页都把 OAI-SearchBot、Claude-SearchBot、PerplexityBot 这类 robots.txt 标识描述为管理搜索可见度的方式。没有一家把 llms.txt 列为排名或引用信号。 我们找不到任何正面或反面的表态,所以说“它们忽略它”和说“它们在用它”一样缺乏依据。关于这些爬虫,以及真正决定你能否被引用的因素,请看我们的产品在 AI 搜索中的可见度指南。
数据说明了什么,又说明不了什么
最常被引用的研究,是 SE Ranking 于 2025年11月7日发布的、对近 30 万个域名的分析。其结论如下:
- 10.13% 的域名拥有 llms.txt 文件。
- 各流量层级的采用率几乎持平:访问量 0 到 100 的网站为 9.88%,1,001 到 5,000 为 10.54%,超过 100,000 为 8.27%。
- Spearman 相关分析和 XGBoost 模型都没有发现 llms.txt 对域名被 AI 模型引用的频率有任何影响。去掉这个变量后,模型反而更准确了。
在使用这些数字之前,我们读了方法部分,有三点局限很重要:
- 这是一项相关性研究。 它比较的是有这个文件的网站和没有的网站,无法说明你添加一个文件之后会发生什么,无论是好是坏。
- 引用数据没有详细说明。 文章没有交代用了哪些模型、哪些提示词、哪个时间段、抽样了多少回答,也没有公布效应量。作者自己也称其结论为 “context-dependent”(视情况而定)。
- 它早于提案的第 2 版,并且出自一家销售 AI 可见度追踪服务的公司。这并不代表它是错的,但值得了解。
所以,诚实的解读是:在这个数据集中,拥有 llms.txt 文件并没有伴随更多的 AI 引用。 这个结论有用,也与 Google 的说法一致。但它并不能证明 llms.txt 对任何引擎都永远无关紧要。如果有人向你承诺 llms.txt 能带来引用,请他拿出证明因果关系而不是相关性的证据。我们还没见过这样的证据。
谁在真正使用 llms.txt
这个文件并非毫无用处。它找到了真正的用武之地,只是不是大多数建议所兜售的那个:
- AI 公司把它用于自家的开发者文档。 2026年10月1日,developers.openai.com/llms.txt、platform.claude.com/llms.txt(从 docs.claude.com 重定向而来)和 docs.perplexity.ai/llms.txt 都返回了 200。OpenAI 的爬虫文档甚至开篇就写着 “For the complete documentation index, see llms.txt.”
- Chrome 的 Lighthouse 会检查它。 Lighthouse 有一个实验性的 “Agentic browsing” 类别(文档最后更新于 2026年5月5日)。它的 llms.txt 审核在无法获取文件时标记为服务器错误,在文件不存在(404)时标记为不适用,理由是 “as providing the file is optional at the moment”,即目前提供该文件是可选的。这是针对智能体的就绪检查,不是排名因素,并且需要 Chrome 150 或更高版本。
- 编程智能体读取它来查阅文档。 提案作者写道,这些文件 “used most heavily for software documentation, where coding agents follow them to find API references and tutorials”,也就是说,它们最常用于软件文档,编程智能体顺着它们找到 API 参考和教程。这正是提案所说的“按需”使用。
规律是:当智能体已经在你的网站上,或即将访问、需要一张地图时,llms.txt 会有帮助。它不会把智能体带到你这里。
LaunchRepo 的做法
我们同时保留两个文件:/llms.txt 和更长的 /llms-full.txt。以下是原因,事实截至 2026年10月1日:
- 维护它们不花我们任何成本。 两个文件都在构建时由与页面相同的数据生成:价格、目录数量、指南、对比。它们不可能与网站内容脱节。
- 它们服务于真实的读者。 LaunchRepo 是一套为编程智能体打造的工具包。当有人问自己的智能体 LaunchRepo 是否适合他们的产品时,一份写清价格和限制的干净摘要能帮助智能体答对。
- 线上的 llms.txt 有 63,009 字节,包含 19 个分区和 177 个链接。这比提案设想的“能轻松放进上下文”的文件要大;智能体可以只读取所需的 H2 分区。
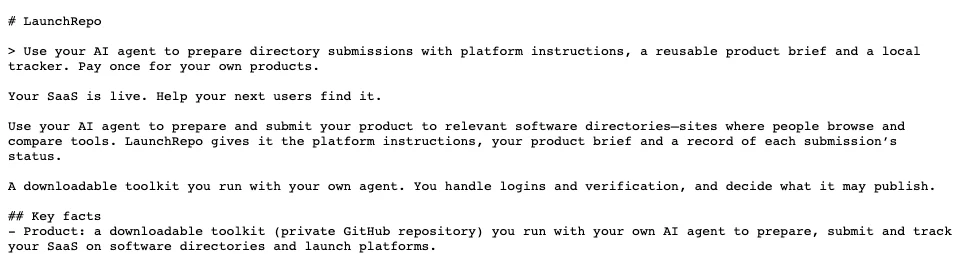
我们不宣称的是:这个文件为我们带来了流量、引用或排名。我们没有分析服务器日志中对 /llms.txt 的请求,所以无法说明它被读取的频率或被谁读取,我们也不会去猜。我们自己的数据工作投入在人和引擎都能引用的页面上,例如目录站状态指数,以及我们关于目录站外链能证明什么、不能证明什么的文章。
你应该做一个吗?
| 你的情况 | 值得吗? | 原因 |
|---|---|---|
| 你有智能体会读取的 API 或开发者文档 | 值得 | 这正是该格式的设计初衷;文档平台通常会自动生成 |
| 你想提升 Google 排名或 AI Overviews 表现 | 不值得 | Google 搜索会忽略这个文件 |
| 你想获得更多 ChatGPT、Claude 或 Perplexity 引用 | 不能当作抓手 | 没有证据表明有效;改为放行它们的搜索爬虫 |
| 你的网站本来就由结构化数据生成 | 添加成本很低 | 自动生成,就永远不会过时 |
| 你需要手动编写和维护 | 优先级低 | 把时间花在一个包含独家事实的页面上 |
如果你要做,就要保证内容准确:价格、套餐、限制,以及产品做不到什么。智能体从你的 llms.txt 中引用一个过时的价格,比根本没有这个文件危害更大。另外,不要专门为 AI 制作特殊页面:Google 的垃圾内容政策同样适用于生成式 AI 回答,它的指南也明确点名了仅为操纵回答而制作内容的做法。
常见问题
llms.txt 能提升 Google 排名吗?
不能。Google 明确表示,Google 搜索会忽略 llms.txt 及类似文件,拥有这样的文件对可见度和排名既无损害也无帮助,AI Overviews 和 AI Mode 也是如此。
ChatGPT 会使用 llms.txt 吗?
OpenAI 没有这样说过。它的爬虫文档把 OAI-SearchBot 和 robots.txt 列为控制 ChatGPT search 的手段,并未提及 llms.txt。不过 OpenAI 确实为自家开发者文档发布了 llms.txt,智能体可以按需读取。
llms.txt 和 robots.txt 是一回事吗?
不是。robots.txt 告诉爬虫可以访问什么。llms.txt 是给智能体的阅读指南,无法允许或屏蔽任何东西。要控制 AI 爬虫,请在 robots.txt 中使用它们公布的标识。
llms.txt 能屏蔽 AI 训练吗?
不能。要屏蔽训练,请使用 GPTBot、ClaudeBot 或 Google-Extended 等 robots.txt 标识。它们与搜索爬虫相互独立,所以你可以屏蔽训练,同时仍出现在 AI 搜索中。
llms.txt 文件会伤害我的网站吗?
Google 表示,它在 Google 搜索中既无损害也无帮助。唯一真正的风险是信息过时:如果文件里写的内容你的页面已经不再这么写,智能体可能会重复错误的版本。
llms-full.txt 是什么?
它不属于 llms.txt 提案,提案的核心是一份简短的索引加上页面的 Markdown 版本。包括我们在内的一些网站会发布第二个文件,收录重要页面的全文,让智能体一次请求就能读完所有内容。截至 2026年10月1日,我们的这个文件为 174,811 字节。
想了解 llms.txt 在所有真正影响 AI 回答的因素中处于什么位置,请阅读我们的产品在 AI 搜索中的可见度指南。如果你的下一步是出现在人们和引擎会去找的地方,请查看价格。
来源,均于 2026年10月1日核查:llmstxt.org(v2,2026年8月10日);Google Search Central,“Optimizing your website for generative AI features”(2026年7月10日更新)及 2026年6月15日的文档更新;SE Ranking,“Does LLMs.txt impact your AI visibility and citations?”(2025年11月7日);Chrome for Developers,Lighthouse llms.txt 审核与 agentic browsing 评分(2026年5月5日);OpenAI、Anthropic 和 Perplexity 的爬虫文档;上文提到的各 llms.txt 文件的 HTTP 状态;2026年10月1日线上提供的 launchrepo.dev/llms.txt。