 LaunchRepo
llms.txt, bir web sitesinin kök dizininde duran ve yapay zeka ajanlarını önemli sayfalara yönlendiren küçük bir Markdown dosyasıdır. Hazırlaması kolaydır ve pek çok tavsiye, bu dosyanın seni ChatGPT’de alıntılatacağını ya da yapay zeka aramasında üst sıralara taşıyacağını vaat eder. Bu yazı, belgelenmiş olanı umulandan ayırıyor. Kısacası: llms.txt Google Arama’da sana yardımcı olmaz, yapay zeka alıntılarını artırdığına dair bir kanıt yoktur ve tek bir iş için gerçekten faydalıdır: ajanların dokümantasyonu okumasına yardım etmek. Biz kendi dosyamızı tutuyoruz ve bunun neden bir çelişki olmadığını aşağıda açıklıyoruz.
llms.txt nedir
Öneri Jeremy Howard’a ait ve 3 Eylül 2024’te llmstxt.org adresinde yayımlandı. Sayfada artık önerinin 2. sürümü yer alıyor ve sayfa en son 10 Ağustos 2026’da değiştirildi. Fikir şu: web sayfaları insanlar için yapılır; metnin etrafında gezinme menüleri, betikler ve sayfa düzeni bulunur. Bir siteyi anlaması gereken bir ajan ise kısa, temiz bir özet ve önemli sayfaların Markdown sürümlerine giden bağlantılarla daha iyi çalışır.
Biçim basit ve sabittir:
- sitenin adını içeren bir H1 (zorunlu olan tek kısım),
- kısa bir özet içeren bir blockquote,
- ayrıntılar için isteğe bağlı paragraflar,
- H2 başlıkları altında, her biri isteğe bağlı bir notla birlikte bağlantı listesi olan bölümler,
- teamül olarak, bir ajanın atlayabileceği bağlantılar için “Optional” adlı bir bölüm.
Öneri, dosyanın ne işe yaradığını açıkça söylüyor: dosya “on demand, when an agent needs information about a topic while assisting a user” (talep üzerine, yani bir ajan bir kullanıcıya yardım ederken bir konu hakkında bilgiye ihtiyaç duyduğunda) okunur. Bu bir izin dosyası değildir. Erişim kuralları robots.txt’de yer alır ve llms.txt hiçbir tarayıcıya izin veremez ya da onu engelleyemez.
Bir SaaS ürünü için asgari bir dosya şöyle görünebilir:
# ExampleApp

> ExampleApp schedules social posts for small teams. Paid plans from $9 per month; free plan with 3 channels.

## Docs
- [Quick start](https://example.com/docs/start.md): set up the first channel
- [API reference](https://example.com/docs/api.md): REST endpoints and limits

## Product
- [Pricing](https://example.com/pricing.md): plans, limits, refunds

## Optional
- [Changelog](https://example.com/changelog.md)
Google ne diyor
Google bu soruyu doğrudan yanıtladı. Üretken yapay zeka özellikleri için optimizasyon rehberi, llms.txt’yi Google Arama açısından görmezden gelebileceğin şeyler arasında sayıyor:
“You don’t need to create new machine readable files, AI text files, markup, or Markdown to appear in Google Search (including its generative AI capabilities), as Google Search itself doesn’t use them.”
Özetle: Google Arama’da (üretken yapay zeka özellikleri dahil) görünmek için yeni makine tarafından okunabilir dosyalar, yapay zeka metin dosyaları, işaretleme ya da Markdown oluşturman gerekmez, çünkü Google Arama bunları kullanmaz.
Google 15 Haziran 2026’da, dokümantasyon güncellemeleri kaydına da işlenen açıklayıcı bir not ekledi. Rehber artık şöyle diyor:
“It’s completely fine if you decide to create and maintain LLMS.txt files (or other similar files) for other services or systems that use these files. Doing so will neither harm nor help your site’s visibility or rankings in Google Search, as Google Search ignores them.”
Özetle: Bu dosyaları kullanan başka hizmetler için LLMS.txt ya da benzeri dosyalar oluşturup sürdürmende hiçbir sakınca yok; Google Arama bunları yok saydığı için sitenin Google Arama’daki görünürlüğüne ya da sıralamasına ne zarar ne de fayda sağlar.
Bu, AI Overviews ve AI Mode dahil Google Arama’yı kapsıyor. ChatGPT, Claude ya da Perplexity hakkında hiçbir şey söylemiyor ve biz de bunu o kadar genişletmemeliyiz.
Peki diğerleri? 1 Ekim 2026 itibarıyla OpenAI, Anthropic ve Perplexity’nin tarayıcı sayfaları, arama görünürlüğünü yönetmenin yolu olarak OAI-SearchBot, Claude-SearchBot ve PerplexityBot gibi robots.txt token’larını tanımlıyor. Hiçbiri llms.txt’den bir sıralama ya da alıntı sinyali olarak söz etmiyor. İki yönde de bir açıklama bulamadık; yani “yok sayıyorlar” demek de “kullanıyorlar” demek kadar kanıtsız olur. Yapay zeka aramasında ürün görünürlüğü rehberimiz bu tarayıcıları ve alıntılanıp alıntılanamayacağını gerçekte neyin belirlediğini ele alıyor.
Veriler ne söylüyor, neyi söyleyemiyor
En sık alıntılanan çalışma, SE Ranking’in 7 Kasım 2025’te yayımladığı ve yaklaşık 300.000 alan adını inceleyen analizi. Bulguları:
- Alan adlarının %10,13’ünde bir llms.txt dosyası vardı.
- Benimsenme oranı trafik düzeyleri arasında neredeyse sabitti: 0 ile 100 ziyaret alan sitelerde %9,88, 1.001 ile 5.000 arasında %10,54, 100.000’den fazla ziyaret alan sitelerde %8,27.
- Spearman korelasyonu ve bir XGBoost modeli, llms.txt’nin bir alan adının yapay zeka modelleri tarafından ne sıklıkla alıntılandığı üzerinde hiçbir etkisini bulamadı. Değişkeni çıkarmak modeli daha isabetli hâle getirdi.
Bu rakamları kullanmadan önce yöntem bölümünü okuduk ve üç sınırlama önemli:
- Bu bir korelasyon çalışmasıdır. Dosyası olan sitelerle olmayanları karşılaştırır. Bir dosya eklesen ne olacağını, hiçbir yönde gösteremez.
- Alıntı verileri ayrıntılı olarak açıklanmamış. Makale hangi modellerin, hangi promptların, hangi dönemin kullanıldığını ya da kaç yanıtın örneklendiğini söylemiyor ve etki büyüklüklerini yayımlamıyor. Yazarlar bulgularını bizzat “context-dependent” (bağlama bağlı) olarak nitelendiriyor.
- Önerinin 2. sürümünden önceye ait ve yapay zeka görünürlük takibi satan bir şirketten geliyor. Bu onu yanlış yapmaz, ama bilmekte fayda var.
Dolayısıyla dürüst okuma şu: bu veri setinde llms.txt dosyasına sahip olmak, daha fazla yapay zeka alıntısıyla birlikte görülmedi. Bu faydalı bir bulgu ve Google’ın açıklamasıyla örtüşüyor. Ama llms.txt’nin hiçbir motor için asla önemli olamayacağının kanıtı değil. Biri sana llms.txt sayesinde alıntı vaat ediyorsa, korelasyonu değil nedenselliği gösteren kanıt iste. Biz böyle bir kanıt görmedik.
llms.txt’yi gerçekte kim kullanıyor
Dosya işe yaramaz değil. Gerçek bir görev buldu, yalnızca tavsiyelerin çoğunun pazarladığı görev bu değil:
- Yapay zeka şirketleri onu kendi geliştirici dokümantasyonları için kullanıyor. 1 Ekim 2026’da developers.openai.com/llms.txt, platform.claude.com/llms.txt (docs.claude.com’dan yönlendirilen) ve docs.perplexity.ai/llms.txt adreslerinin hepsi 200 döndürdü. OpenAI’ın tarayıcı dokümantasyonu bile “For the complete documentation index, see llms.txt.” (Dokümantasyonun tam dizini için llms.txt’ye bak.) cümlesiyle açılıyor.
- Chrome’un Lighthouse aracı onu kontrol ediyor. Lighthouse’ta deneysel bir “Agentic browsing” kategorisi var (dokümantasyonun son güncellemesi 5 Mayıs 2026). Bu kategorideki llms.txt denetimi, dosya alınamadığında bir sunucu hatası bildiriyor ve eksik bir dosyayı (404) “as providing the file is optional at the moment” (dosyayı sağlamak şimdilik isteğe bağlı olduğu için) gerekçesiyle uygulanamaz olarak işaretliyor. Bu bir sıralama faktörü değil, ajanlara hazır olma kontrolü ve Chrome 150 ya da daha yeni bir sürüm gerektiriyor.
- Kodlama ajanları onu dokümantasyon için okuyor. Önerinin yazarı, dosyaların “used most heavily for software documentation, where coding agents follow them to find API references and tutorials” (en yoğun olarak yazılım dokümantasyonunda kullanıldığını; kodlama ajanlarının API referanslarını ve eğitimleri bulmak için bunları izlediğini) yazıyor. Bu, önerinin tarif ettiği “on demand” (talep üzerine) kullanımdır.
Örüntü şu: llms.txt, bir ajan zaten sitendeyken ya da gelmek üzereyken ve bir haritaya ihtiyaç duyduğunda yardımcı olur. Ajanı oraya getirmez.
LaunchRepo’da ne yapıyoruz
İki dosyayı da tutuyoruz: /llms.txt ve daha uzun olan /llms-full.txt. Nedenleri, 1 Ekim 2026 itibarıyla geçerli bilgilerle:
- Bakımları bize hiçbir şeye mal olmuyor. İkisi de derleme sırasında sayfalarımızla aynı verilerden üretiliyor: fiyatlar, katalog sayıları, rehberler, karşılaştırmalar. Siteden kopamazlar.
- Gerçek bir okura hizmet ediyorlar. LaunchRepo, kodlama ajanları için bir araç seti. Biri ajanına LaunchRepo’nun kendi ürününe uyup uymadığını sorduğunda, fiyatları ve sınırları içeren temiz bir özet o ajanın doğru yanıt vermesine yardımcı oluyor.
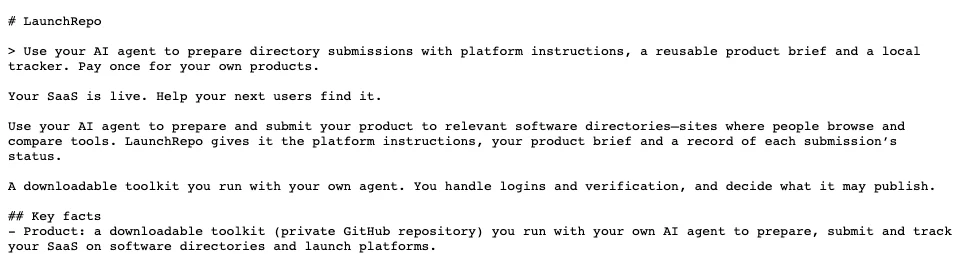
- Yayındaki llms.txt 63.009 bayt, 19 bölüm ve 177 bağlantı içeriyor. Bu, önerinin bağlama rahatça sığan dosya fikrinden daha büyük; ajanlar ihtiyaç duydukları H2 bölümlerini okuyabilir.
İddia etmediğimiz şey: dosyanın bize trafik, alıntı ya da sıralama getirdiği. Sunucu kayıtlarımızı /llms.txt isteklerine göre analiz etmedik; bu yüzden ne sıklıkla ve kim tarafından okunduğunu söyleyemeyiz ve tahmin de yürütmeyeceğiz. Kendi veri çalışmalarımızı, insanların ve motorların alıntılayabileceği sayfalara harcıyoruz; örneğin dizin durum endeksi ve dizin backlink’lerinin neyi kanıtlayıp neyi kanıtlayamayacağı üzerine yazımız.
Bir tane oluşturmalı mısın?
| Durumun | Değer mi? | Neden |
|---|---|---|
| Ajanların okuduğu API ya da geliştirici dokümantasyonun var | Evet | Biçim tam olarak bunun için yapıldı; dokümantasyon platformları onu çoğu zaman otomatik üretir |
| Google sıralamalarını ya da AI Overviews’taki yerini iyileştirmek istiyorsun | Hayır | Google Arama dosyayı yok sayar |
| ChatGPT, Claude ya da Perplexity’de daha fazla alıntı istiyorsun | Bir kaldıraç olarak değil | Etkisine dair kanıt yok; bunun yerine arama tarayıcılarına izin ver |
| Siten zaten yapılandırılmış veriden üretiliyor | Eklemesi ucuz | Otomatik üret, böylece asla eskimez |
| Dosyayı elle yazıp güncel tutman gerekecek | Düşük öncelik | O zamanı, başka kimsede olmayan bilgiler içeren bir sayfaya harca |
Bir tane oluşturursan doğru tut: fiyat, planlar, sınırlar ve ürünün neyi yapmadığı. llms.txt dosyandan eskimiş bir fiyatı aktaran bir ajan, hiç dosya olmamasından daha fazla zarar verir. Ayrıca yalnızca yapay zeka için özel sayfalar oluşturma: Google’ın spam politikaları üretken yapay zeka yanıtları için de geçerli ve rehberi, sırf bu yanıtları manipüle etmek için içerik üretmeyi açıkça anıyor.
Sık sorulan sorular
llms.txt Google sıralamalarını iyileştirir mi?
Hayır. Google, Google Arama’nın llms.txt ve benzeri dosyaları yok saydığını ve böyle bir dosyaya sahip olmanın, AI Overviews ve AI Mode dahil, görünürlüğe ya da sıralamaya ne zarar ne de fayda sağlayacağını belirtiyor.
ChatGPT llms.txt kullanıyor mu?
OpenAI böyle bir şey söylemedi. Tarayıcı dokümantasyonu, ChatGPT araması için kontrol aracı olarak OAI-SearchBot’u ve robots.txt’yi gösteriyor ve llms.txt’den söz etmiyor. Bununla birlikte OpenAI, kendi geliştirici dokümantasyonu için ajanların talep üzerine okuyabileceği bir llms.txt yayımlıyor.
llms.txt ile robots.txt aynı şey mi?
Hayır. robots.txt, tarayıcılara neye erişebileceklerini söyler. llms.txt ise ajanlar için bir okuma rehberidir ve hiçbir şeye izin veremez ya da hiçbir şeyi engelleyemez. Yapay zeka tarayıcılarını kontrol etmek için robots.txt’yi onların yayımlanmış token’larıyla kullan.
llms.txt yapay zeka eğitimini engelleyebilir mi?
Hayır. Bunun için GPTBot, ClaudeBot ya da Google-Extended gibi robots.txt token’larını kullan. Bunlar arama tarayıcılarından ayrıdır; yani eğitimi engelleyip yapay zeka aramasında görünmeye devam edebilirsin.
llms.txt dosyası siteme zarar verir mi?
Google, Google Arama’da ne zararı ne de faydası olduğunu söylüyor. Tek gerçek risk eskimiş bilgidir: dosya, sayfalarının artık söylemediği bir şeyi söylüyorsa ajanlar yanlış sürümü tekrarlayabilir.
llms-full.txt nedir?
llms.txt önerisinin bir parçası değildir; öneri, kısa bir dizin ve sayfaların Markdown sürümleri üzerine kurulu. Bizimki de dahil bazı siteler, önemli sayfaların tam metnini içeren ikinci bir dosya yayımlar; böylece bir ajan her şeyi tek bir istekte okuyabilir. Bizimki 1 Ekim 2026’da 174.811 bayttı.
llms.txt’nin, yapay zeka yanıtlarını gerçekten etkileyen her şeyin yanında nerede durduğunu görmek için yapay zeka aramasında ürün görünürlüğü rehberimizi oku. Bir sonraki adımın, insanların ve motorların baktığı yerlerde listelenmekse fiyatlandırma sayfasına göz at.
Kaynaklar, tümü 1 Ekim 2026’da kontrol edildi: llmstxt.org (v2, 10 Ağustos 2026); Google Search Central, “Optimizing your website for generative AI features” (10 Temmuz 2026’da güncellendi) ve 15 Haziran 2026 tarihli dokümantasyon güncellemeleri; SE Ranking, “Does LLMs.txt impact your AI visibility and citations?” (7 Kasım 2025); Chrome for Developers, Lighthouse llms.txt denetimi ve agentic browsing puanlaması (5 Mayıs 2026); OpenAI, Anthropic ve Perplexity tarayıcı dokümantasyonu; yukarıda adı geçen llms.txt dosyalarının HTTP durumu; 1 Ekim 2026’da sunulduğu haliyle launchrepo.dev/llms.txt.