 LaunchRepo
llms.txtは、ウェブサイトのルートに置く小さなMarkdownファイルで、AIエージェントに重要なページを案内します。作るのは簡単で、ChatGPTに引用される、AI検索で上位に出るといった効果をうたうアドバイスもたくさんあります。この記事では、文書で裏付けられていることと、期待にすぎないことを切り分けます。結論を先に言うと、llms.txtはGoogle検索では役に立たず、AIでの引用を増やすという証拠もありません。一方で、エージェントがドキュメントを読むのを助けるという1つの仕事では本当に役立ちます。 私たちは自社のファイルを残していますが、それが矛盾しない理由も以下で説明します。
llms.txtとは
この提案はJeremy Howardによるもので、2024年9月3日にllmstxt.orgで公開されました。現在このページには提案のバージョン2が掲載されており、最終更新日は2026年8月10日です。考え方はこうです。ウェブページは人のために作られていて、本文の周りにナビゲーション、スクリプト、レイアウトがあります。サイトを理解する必要があるエージェントにとっては、短く整理された要約と、重要なページのMarkdown版へのリンクがあるほうが作業しやすい、というものです。
フォーマットはシンプルで、決まっています。
- サイト名を書いたH1(必須なのはこれだけ)
- 短い要約を書いた引用ブロック
- 詳細を書いた任意の段落
- H2見出しの下のセクション。それぞれがリンクのリストで、任意で注記を付けられる
- 慣例として、エージェントが読み飛ばしてよいリンクをまとめた「Optional」というセクション
提案は、このファイルの用途をはっきり書いています。読まれるのは “on demand, when an agent needs information about a topic while assisting a user” です。つまり、エージェントがユーザーを手伝う中で、あるテーマの情報が必要になったときに必要に応じて読まれるものです。これはアクセス許可のファイルではありません。アクセスのルールはrobots.txtにあり、llms.txtでクローラーを許可したりブロックしたりすることはできません。
SaaS製品向けの最小限のファイルは、たとえば次のようになります。
# ExampleApp

> ExampleApp schedules social posts for small teams. Paid plans from $9 per month; free plan with 3 channels.

## Docs
- [Quick start](https://example.com/docs/start.md): set up the first channel
- [API reference](https://example.com/docs/api.md): REST endpoints and limits

## Product
- [Pricing](https://example.com/pricing.md): plans, limits, refunds

## Optional
- [Changelog](https://example.com/changelog.md)
Googleの見解
Googleはこの問いに直接答えています。生成AI機能向けの最適化ガイドでは、llms.txtを、Google検索では気にしなくてよいものの1つとして挙げています。
“You don’t need to create new machine readable files, AI text files, markup, or Markdown to appear in Google Search (including its generative AI capabilities), as Google Search itself doesn’t use them.”
つまり、Google検索(生成AI機能を含む)に表示されるために、新しい機械可読ファイル、AI向けテキストファイル、マークアップ、Markdownを作る必要はなく、Google検索自体はそれらを使わない、ということです。
2026年6月15日、Googleは補足の注記を加え、ドキュメントの更新履歴に記録しました。ガイドの現在の記述は次のとおりです。
“It’s completely fine if you decide to create and maintain LLMS.txt files (or other similar files) for other services or systems that use these files. Doing so will neither harm nor help your site’s visibility or rankings in Google Search, as Google Search ignores them.”
要するに、こうしたファイルを使うほかのサービスやシステムのためにLLMS.txtを作って維持するのはまったく問題ないが、Google検索はそれを無視するので、Google検索での見え方や順位にはプラスにもマイナスにもならない、ということです。
これはAI OverviewsやAI Modeを含むGoogle検索についての話です。ChatGPT、Claude、Perplexityについては何も述べておらず、そこまで拡大解釈すべきではありません。
ほかの会社はどうでしょうか。2026年10月1日時点で、OpenAI、Anthropic、Perplexityのクローラー関連ページは、OAI-SearchBot、Claude-SearchBot、PerplexityBotといったrobots.txtのトークンを、検索での見え方を管理する手段として説明しています。どの会社も、llms.txtを順位や引用のシグナルとしては挙げていません。 肯定する記述も否定する記述も見つからなかったので、「無視している」と言うのも「使っている」と言うのと同じくらい根拠がありません。これらのクローラーと、引用されるかどうかを実際に決める要素については、AI検索での製品の見え方に関するガイドで解説しています。
データが示すこと、示せないこと
最もよく引用される調査は、SE Rankingが約30万ドメインを分析し、2025年11月7日に公開したものです。主な結果は次のとおりです。
- ドメインの10.13%がllms.txtファイルを置いていた。
- 導入率はトラフィックの規模によらずほぼ横ばいだった。訪問数0〜100のサイトで9.88%、1,001〜5,000で10.54%、100,000超で8.27%。
- Spearmanの相関とXGBoostモデルでは、llms.txtがドメインのAIモデルによる引用頻度に与える影響は見つからなかった。この変数を取り除くと、モデルの精度はむしろ上がった。
私たちはこれらの数字を使う前に手法のセクションを読みました。重要な限界は3つあります。
- これは相関の調査です。 ファイルがあるサイトとないサイトを比べているだけです。ファイルを追加したらどうなるかは、良い方向にも悪い方向にも示せません。
- 引用データの詳細が説明されていません。 どのモデル、どのプロンプト、どの期間、何件の回答をサンプルにしたかが書かれておらず、効果量も公開されていません。著者自身も結果を “context-dependent”(状況次第)と呼んでいます。
- 提案のバージョン2より前の調査で、しかもAIでの見え方の追跡ツールを販売している会社によるものです。だから間違っているわけではありませんが、知っておく価値はあります。
したがって、正直な読み方はこうなります。このデータセットでは、llms.txtファイルがあることとAIでの引用が多いことは結び付いていなかった。 これは有益な結果で、Googleの見解とも一致します。ただし、llms.txtがどのエンジンにとっても決して意味を持たないという証明ではありません。llms.txtで引用が増えると約束する人がいたら、相関ではなく因果を示す証拠を求めてください。私たちはまだそうした証拠を見たことがありません。
llms.txtを実際に使っているのは誰か
このファイルは無駄ではありません。多くのアドバイスが売り込む用途とは違いますが、本当の役割を見つけています。
- AI企業は自社の開発者向けドキュメントに使っています。 2026年10月1日、developers.openai.com/llms.txt、platform.claude.com/llms.txt(docs.claude.comからリダイレクト)、docs.perplexity.ai/llms.txtはいずれも200を返しました。OpenAIのクローラーのドキュメントは、冒頭から “For the complete documentation index, see llms.txt.” と書いています。
- ChromeのLighthouseがチェックしています。 Lighthouseには実験的な「Agentic browsing」カテゴリがあります(ドキュメントの最終更新は2026年5月5日)。そのllms.txt監査は、ファイルを取得できない場合はサーバーエラーとして指摘し、ファイルがない場合(404)は “as providing the file is optional at the moment”、つまり現時点ではファイルの提供は任意だという理由で対象外とします。これはエージェントへの対応状況のチェックであって順位の要因ではなく、Chrome 150以降が必要です。
- コーディングエージェントはドキュメントを読むために使っています。 提案者は、このファイルが “used most heavily for software documentation, where coding agents follow them to find API references and tutorials” と書いています。ソフトウェアのドキュメントで最もよく使われ、コーディングエージェントがAPIリファレンスやチュートリアルを探すためにたどっている、ということです。これが提案の言う「必要に応じて」の使い方です。
傾向をまとめると、llms.txtが役立つのは、エージェントがすでにあなたのサイトにいるか、これから来るところで、地図を必要としているときです。エージェントをそこへ連れてくるものではありません。
LaunchRepoでの取り組み
私たちは2つのファイルを置いています。/llms.txtと、より長い/llms-full.txtです。その理由を、2026年10月1日時点の事実とともに説明します。
- 維持にコストがかかりません。 どちらもビルド時に、ページと同じデータ(価格、カタログの件数、ガイド、比較)から生成されます。サイトの内容とずれることがありません。
- 実際の読み手がいます。 LaunchRepoはコーディングエージェントのためのツールキットです。誰かが自分のエージェントに「LaunchRepoは自分の製品に合うか」と尋ねたとき、価格と制限が書かれた整理された要約があれば、エージェントは正しく答えやすくなります。
- 公開中のllms.txtは63,009バイトで、19のセクションと177のリンクがあります。これは、コンテキストに楽に収まるファイルという提案の想定より大きいですが、エージェントは必要なH2セクションだけを読むことができます。
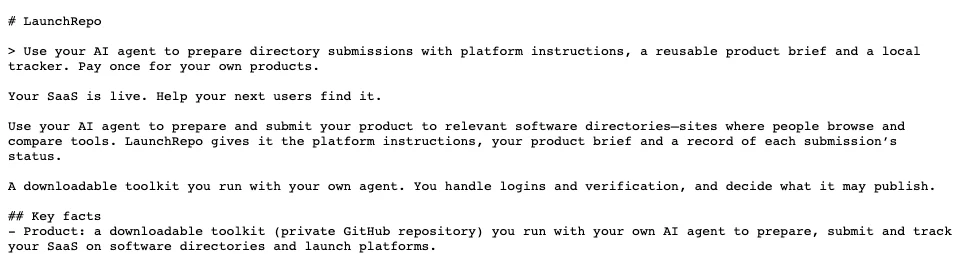
私たちが主張しないこと:このファイルがトラフィック、引用、順位をもたらしているということ。/llms.txtへのリクエストについてサーバーログを分析していないので、どのくらいの頻度で誰に読まれているかは言えませんし、推測もしません。私たち自身のデータ作業は、人やエンジンが引用できるページに注いでいます。たとえばディレクトリのステータス指数や、ディレクトリの被リンクで証明できること・できないことについての記事です。
作るべきか?
| あなたの状況 | 作る価値は? | 理由 |
|---|---|---|
| エージェントが読むAPIや開発者向けドキュメントがある | はい | このフォーマットが作られた目的そのもの。ドキュメント基盤が自動生成することも多い |
| Googleでの順位やAI Overviewsを上げたい | いいえ | Google検索はこのファイルを無視する |
| ChatGPT、Claude、Perplexityでの引用を増やしたい | 手段としては期待できない | 効果の証拠はない。代わりに各社の検索クローラーを許可する |
| サイトがもともと構造化データから生成されている | 追加の手間は小さい | 自動生成すれば古くならない |
| 手作業で書いて維持することになる | 優先度は低い | その時間を、ほかの誰も持っていない事実を載せたページに使う |
作るなら、内容を正確に保ってください。価格、プラン、制限、そして製品ができないこと。llms.txtにある古い価格をエージェントが引用してしまうと、ファイルがない場合より悪い結果になります。また、AIのためだけの特別なページは作らないでください。Googleのスパムポリシーは生成AIの回答にも適用され、ガイドでも、回答を操作するためだけにコンテンツを作ることをはっきり戒めています。
よくある質問
llms.txtでGoogleの順位は上がりますか?
いいえ。Googleは、Google検索はllms.txtや類似のファイルを無視し、それを置いても見え方や順位にはプラスにもマイナスにもならないと明言しています。AI OverviewsやAI Modeも同じです。
ChatGPTはllms.txtを使っていますか?
OpenAIはそう述べていません。同社のクローラーのドキュメントは、ChatGPT searchを管理する手段としてOAI-SearchBotとrobots.txtを挙げており、llms.txtには触れていません。一方でOpenAIは自社の開発者向けドキュメントにllms.txtを公開しており、エージェントは必要に応じてそれを読めます。
llms.txtはrobots.txtと同じものですか?
いいえ。robots.txtは、クローラーが何にアクセスしてよいかを伝えます。llms.txtはエージェント向けの読書ガイドで、何かを許可したりブロックしたりすることはできません。AIクローラーを管理するには、各社が公開しているトークンを使ってrobots.txtで設定します。
llms.txtでAIの学習をブロックできますか?
いいえ。それにはGPTBot、ClaudeBot、Google-Extendedといったrobots.txtのトークンを使います。これらは検索クローラーとは別なので、学習をブロックしながらAI検索には表示され続けることができます。
llms.txtファイルはサイトに悪影響がありますか?
Googleによると、Google検索ではプラスにもマイナスにもなりません。現実的なリスクは古い情報だけです。ページにもう書かれていない内容がファイルに残っていると、エージェントが間違った情報を繰り返すおそれがあります。
llms-full.txtとは何ですか?
llms.txtの提案には含まれていません。提案の中心は、短いインデックスとページのMarkdown版です。私たちを含む一部のサイトは、重要なページの全文をまとめた2つ目のファイルを公開しており、エージェントは1回のリクエストですべてを読めます。私たちのファイルは2026年10月1日時点で174,811バイトでした。
AIの回答に実際に影響する要素全体の中でllms.txtがどこに位置するかは、AI検索での製品の見え方に関するガイドをご覧ください。次のステップが、人とエンジンが探す場所に掲載されることなら、料金をご覧ください。
出典(すべて2026年10月1日に確認):llmstxt.org(v2、2026年8月10日)、Google Search Central「Optimizing your website for generative AI features」(2026年7月10日更新)および2026年6月15日のドキュメント更新、SE Ranking「Does LLMs.txt impact your AI visibility and citations?」(2025年11月7日)、Chrome for Developers、Lighthouseのllms.txt監査とAgentic browsingのスコアリング(2026年5月5日)、OpenAI・Anthropic・Perplexityのクローラーに関するドキュメント、上記llms.txtファイルのHTTPステータス、2026年10月1日時点で配信されていたlaunchrepo.dev/llms.txt。