 LaunchRepo
llms.txt to mały plik Markdown w katalogu głównym strony, który wskazuje agentom AI najważniejsze podstrony. Łatwo go przygotować, a wiele porad obiecuje, że dzięki niemu ChatGPT zacznie cię cytować albo awansujesz w wyszukiwaniu AI. Ten artykuł oddziela to, co udokumentowane, od tego, na co ktoś liczy. W skrócie: llms.txt nie pomaga w wyszukiwarce Google, nie ma dowodów, że zwiększa liczbę cytowań w AI, i jest naprawdę przydatny w jednym zadaniu: pomaga agentom czytać dokumentację. My swój plik zostawiamy i niżej wyjaśniamy, dlaczego to nie jest sprzeczność.
Czym jest llms.txt
Propozycja pochodzi od Jeremy’ego Howarda i została opublikowana na llmstxt.org 3 września 2024. Strona zawiera obecnie wersję 2 propozycji, a ostatnio zmieniono ją 10 sierpnia 2026. Idea: strony internetowe powstają dla ludzi, z nawigacją, skryptami i układem graficznym wokół tekstu. Agent, który ma zrozumieć witrynę, radzi sobie lepiej z krótkim, czystym podsumowaniem i linkami do wersji Markdown najważniejszych stron.
Format jest prosty i ściśle określony:
- nagłówek H1 z nazwą witryny (jedyna wymagana część),
- cytat blokowy z krótkim podsumowaniem,
- opcjonalne akapity ze szczegółami,
- sekcje pod nagłówkami H2, każda z listą linków i opcjonalną notatką,
- zwyczajowo sekcja o nazwie „Optional” z linkami, które agent może pominąć.
Propozycja jasno mówi, do czego służy plik: jest czytany „on demand, when an agent needs information about a topic while assisting a user”, czyli na żądanie, gdy agent pomagający użytkownikowi potrzebuje informacji na jakiś temat. To nie jest plik uprawnień. Reguły dostępu są w robots.txt, a llms.txt nie może ani dopuścić, ani zablokować żadnego crawlera.
Minimalny plik dla produktu SaaS mógłby wyglądać tak:
# ExampleApp

> ExampleApp schedules social posts for small teams. Paid plans from $9 per month; free plan with 3 channels.

## Docs
- [Quick start](https://example.com/docs/start.md): set up the first channel
- [API reference](https://example.com/docs/api.md): REST endpoints and limits

## Product
- [Pricing](https://example.com/pricing.md): plans, limits, refunds

## Optional
- [Changelog](https://example.com/changelog.md)
Co mówi Google
Google odpowiedział na to pytanie wprost. Jego przewodnik po optymalizacji pod funkcje generatywnej AI wymienia llms.txt wśród rzeczy, które możesz zignorować w kontekście wyszukiwarki Google:
“You don’t need to create new machine readable files, AI text files, markup, or Markdown to appear in Google Search (including its generative AI capabilities), as Google Search itself doesn’t use them.”
W skrócie: nie musisz tworzyć nowych plików czytelnych dla maszyn, plików tekstowych dla AI, znaczników ani Markdownu, żeby pojawić się w wyszukiwarce Google (także w jej funkcjach generatywnej AI), bo sama wyszukiwarka Google z nich nie korzysta.
15 czerwca 2026 Google dodał doprecyzowanie, odnotowane w dzienniku zmian dokumentacji. Przewodnik brzmi teraz tak:
“It’s completely fine if you decide to create and maintain LLMS.txt files (or other similar files) for other services or systems that use these files. Doing so will neither harm nor help your site’s visibility or rankings in Google Search, as Google Search ignores them.”
W skrócie: możesz spokojnie tworzyć i utrzymywać pliki LLMS.txt (lub podobne) dla innych usług czy systemów, które z nich korzystają. Nie zaszkodzi to ani nie pomoże widoczności czy pozycjom twojej witryny w wyszukiwarce Google, bo wyszukiwarka Google je ignoruje.
Dotyczy to wyszukiwarki Google, w tym AI Overviews i AI Mode. Nie mówi nic o ChatGPT, Claude ani Perplexity i nie powinniśmy tego tak daleko rozciągać.
A pozostali? Według stanu na 1 października 2026 strony o crawlerach OpenAI, Anthropic i Perplexity opisują tokeny robots.txt, takie jak OAI-SearchBot, Claude-SearchBot i PerplexityBot, jako sposób zarządzania widocznością w wyszukiwaniu. Żadna z nich nie wymienia llms.txt jako sygnału dla rankingu ani cytowań. Nie znaleźliśmy deklaracji ani w jedną, ani w drugą stronę, więc stwierdzenie „ignorują go” byłoby równie nieudowodnione jak „korzystają z niego”. Nasz poradnik o widoczności produktu w wyszukiwaniu AI omawia te crawlery i to, co naprawdę decyduje o tym, czy możesz zostać zacytowany.
Co mówią dane, a czego powiedzieć nie mogą
Najczęściej przywoływane badanie to analiza SE Ranking obejmująca prawie 300 000 domen, opublikowana 7 listopada 2025. Jej wyniki:
- 10,13% domen miało plik llms.txt.
- Popularność była niemal taka sama na wszystkich poziomach ruchu: 9,88% dla witryn z 0 do 100 odwiedzinami, 10,54% dla 1001 do 5000, 8,27% dla witryn z ponad 100 000.
- Korelacja Spearmana i model XGBoost nie wykazały żadnego wpływu llms.txt na to, jak często modele AI cytowały domenę. Po usunięciu tej zmiennej model stał się wręcz dokładniejszy.
Zanim użyliśmy tych liczb, przeczytaliśmy część o metodologii. Ważne są trzy ograniczenia:
- To badanie korelacyjne. Porównuje witryny, które mają plik, z witrynami, które go nie mają. Nie pokazuje, co by się stało, gdybyś go dodał, w żadną stronę.
- Dane o cytowaniach nie są szczegółowo opisane. Artykuł nie podaje, jakie modele, jakie prompty, jaki okres ani ile odpowiedzi przeanalizowano, i nie publikuje wielkości efektów. Sami autorzy nazywają swoje wyniki „context-dependent”, czyli zależnymi od kontekstu.
- Powstało przed wersją 2 propozycji i pochodzi od firmy, która sprzedaje śledzenie widoczności w AI. To nie czyni go błędnym, ale warto o tym wiedzieć.
Uczciwa interpretacja brzmi więc: w tym zbiorze danych posiadanie pliku llms.txt nie szło w parze z większą liczbą cytowań w AI. To przydatna informacja i zgadza się z deklaracją Google. Nie jest to jednak dowód, że llms.txt nigdy nie może mieć znaczenia dla żadnej wyszukiwarki. Jeśli ktoś obiecuje ci cytowania dzięki llms.txt, poproś o dowody, które pokazują przyczynę, a nie korelację. My takich nie widzieliśmy.
Kto naprawdę używa llms.txt
Plik nie jest bezużyteczny. Znalazł prawdziwe zastosowanie, tylko inne niż to, które sprzedaje większość porad:
- Firmy AI używają go we własnej dokumentacji dla deweloperów. 1 października 2026 adresy developers.openai.com/llms.txt, platform.claude.com/llms.txt (przekierowanie z docs.claude.com) i docs.perplexity.ai/llms.txt zwracały status 200. Dokumentacja crawlerów OpenAI zaczyna się wręcz od zdania „For the complete documentation index, see llms.txt.”
- Lighthouse w Chrome go sprawdza. Lighthouse ma eksperymentalną kategorię „Agentic browsing” (dokumentacja ostatnio aktualizowana 5 maja 2026). Jej audyt llms.txt zgłasza błąd serwera, gdy pliku nie da się pobrać, a brak pliku (404) oznacza jako nie dotyczy, „as providing the file is optional at the moment”, bo na razie plik jest opcjonalny. To test gotowości na agentów, a nie czynnik rankingowy, i wymaga Chrome 150 lub nowszego.
- Agenci kodujący czytają go, by poznać dokumentację. Autor propozycji pisze, że pliki są „used most heavily for software documentation, where coding agents follow them to find API references and tutorials”, czyli najczęściej w dokumentacji oprogramowania, gdzie agenci kodujący podążają za nimi do opisów API i tutoriali. To właśnie użycie „on demand”, które opisuje propozycja.
Wzorzec jest taki: llms.txt pomaga, gdy agent już jest na twojej stronie albo zaraz na nią trafi i potrzebuje mapy. Nie sprowadza agenta na stronę.
Co robimy w LaunchRepo
Utrzymujemy oba pliki: /llms.txt i dłuższy /llms-full.txt. Oto dlaczego, według stanu na 1 października 2026:
- Ich utrzymanie nic nas nie kosztuje. Oba są generowane podczas budowania strony z tych samych danych co nasze podstrony: cen, liczb z katalogu, poradników, porównań. Nie mogą rozjechać się ze stroną.
- Mają prawdziwego czytelnika. LaunchRepo to zestaw narzędzi dla agentów kodujących. Gdy ktoś pyta swojego agenta, czy LaunchRepo pasuje do jego produktu, czyste podsumowanie z cenami i limitami pomaga temu agentowi odpowiedzieć poprawnie.
- Udostępniany llms.txt ma 63 009 bajtów, 19 sekcji i 177 linków. To więcej, niż zakłada propozycja, która mówi o pliku łatwo mieszczącym się w kontekście; agenci mogą czytać tylko te sekcje H2, których potrzebują.
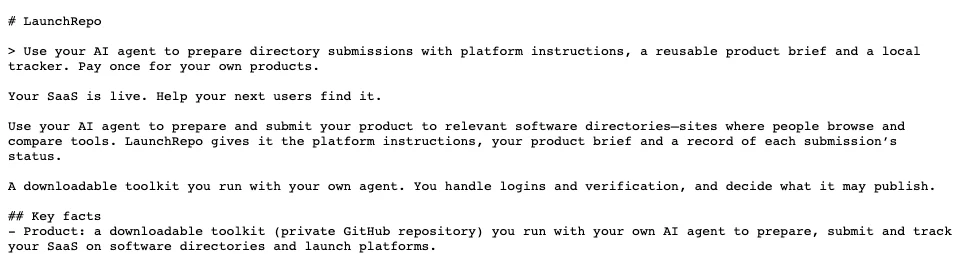
Czego nie twierdzimy: że plik przynosi nam ruch, cytowania lub pozycje. Nie analizowaliśmy logów serwera pod kątem zapytań o /llms.txt, więc nie wiemy, jak często i przez kogo jest czytany, i nie będziemy zgadywać. Naszą pracę z danymi wkładamy w strony, które ludzie i wyszukiwarki mogą cytować, takie jak indeks statusu katalogów startowych i nasz artykuł o tym, czego backlinki z katalogów mogą dowieść, a czego nie.
Czy warto go przygotować?
| Twoja sytuacja | Czy warto? | Dlaczego |
|---|---|---|
| Masz dokumentację API lub dla deweloperów, którą czytają agenci | Tak | Do tego format został stworzony; platformy dokumentacyjne często generują go same |
| Chcesz lepszych pozycji w Google lub w AI Overviews | Nie | Wyszukiwarka Google ignoruje ten plik |
| Chcesz więcej cytowań w ChatGPT, Claude lub Perplexity | Nie jako dźwignia | Brak dowodów na efekt; zamiast tego wpuść ich crawlery wyszukiwania |
| Twoja strona i tak jest generowana z danych strukturalnych | Tani dodatek | Generuj go, a nigdy się nie zdezaktualizuje |
| Pisałbyś go i utrzymywał ręcznie | Niski priorytet | Poświęć ten czas na stronę z faktami, których nikt inny nie ma |
Jeśli go przygotujesz, dbaj o jego poprawność: cena, plany, limity i to, czego produkt nie robi. Agent, który cytuje nieaktualną cenę z twojego llms.txt, szkodzi bardziej niż brak pliku. I nie twórz specjalnych stron tylko dla AI: zasady Google dotyczące spamu obejmują także odpowiedzi generatywnej AI, a jego przewodnik wprost wymienia tworzenie treści wyłącznie po to, by nimi manipulować.
Najczęściej zadawane pytania
Czy llms.txt poprawia pozycje w Google?
Nie. Google stwierdza, że wyszukiwarka Google ignoruje llms.txt i podobne pliki, a ich posiadanie ani nie szkodzi, ani nie pomaga widoczności czy pozycjom, także w AI Overviews i AI Mode.
Czy ChatGPT korzysta z llms.txt?
OpenAI tego nie ogłosiło. Jego dokumentacja crawlerów wskazuje OAI-SearchBot i robots.txt jako narzędzia kontroli dla wyszukiwarki ChatGPT i nie wspomina o llms.txt. OpenAI publikuje jednak llms.txt dla własnej dokumentacji dla deweloperów, który agenci mogą czytać na żądanie.
Czy llms.txt to to samo co robots.txt?
Nie. robots.txt mówi crawlerom, do czego mają dostęp. llms.txt to przewodnik do czytania dla agentów i nie może niczego dopuścić ani zablokować. Aby kontrolować crawlery AI, użyj robots.txt z ich opublikowanymi tokenami.
Czy llms.txt może zablokować trening AI?
Nie. Do tego służą tokeny robots.txt, takie jak GPTBot, ClaudeBot czy Google-Extended. Są oddzielone od crawlerów wyszukiwania, więc możesz zablokować trening i nadal pojawiać się w wyszukiwaniu AI.
Czy plik llms.txt szkodzi mojej stronie?
Google mówi, że w wyszukiwarce Google ani nie szkodzi, ani nie pomaga. Jedynym realnym ryzykiem są nieaktualne informacje: jeśli plik mówi coś, czego twoje strony już nie mówią, agenci mogą powtarzać błędną wersję.
Czym jest llms-full.txt?
Nie jest częścią propozycji llms.txt, która opiera się na krótkim indeksie i wersjach Markdown stron. Niektóre witryny, w tym nasza, publikują drugi plik z pełną treścią najważniejszych stron, aby agent mógł przeczytać wszystko w jednym zapytaniu. Nasz miał 174 811 bajtów 1 października 2026.
Aby zobaczyć, gdzie llms.txt plasuje się obok wszystkiego, co naprawdę wpływa na odpowiedzi AI, przeczytaj nasz poradnik o widoczności produktu w wyszukiwaniu AI. Jeśli twoim następnym krokiem jest pojawienie się tam, gdzie szukają ludzie i wyszukiwarki, zobacz cennik.
Źródła, wszystkie sprawdzone 1 października 2026: llmstxt.org (v2, 10 sierpnia 2026); Google Search Central, „Optimizing your website for generative AI features” (aktualizacja 10 lipca 2026) oraz zmiany w dokumentacji z 15 czerwca 2026; SE Ranking, „Does LLMs.txt impact your AI visibility and citations?” (7 listopada 2025); Chrome for Developers, audyt llms.txt w Lighthouse i ocena agentic browsing (5 maja 2026); dokumentacja crawlerów OpenAI, Anthropic i Perplexity; status HTTP wymienionych wyżej plików llms.txt; launchrepo.dev/llms.txt w wersji udostępnianej 1 października 2026.